




Actualités
ChatGPT n’a pas encore son moteur de recherche : ce que change vraiment Labrador
Pendant deux ans, une règle a circulé dans tous les ateliers GEO : « Pour exister dans ChatGPT, soignez votre référencement Bing. » Cette règle est en train de tomber. Sur un échantillon de 88 000 résultats de recherche analysés en juillet 2026, seulement 1,5 % des URL servies par l’index interne d’OpenAI apparaissaient aussi dans le top 20 de Bing pour les mêmes requêtes. Autrement dit : ChatGPT ne recopie plus Bing. Il a son propre index. Et cet index porte un nom de chien. Il s’appelle Labrador. Le choix n’est sans doute pas un hasard. En anglais, le labrador est un retriever, un chien qui rapporte. Et en recherche d’information, retrieval, c’est précisément l’étape qui consiste à aller chercher les documents avant de rédiger la réponse. OpenAI a donc baptisé sa brique… du nom de la fonction qu’elle remplit. (On a connu des ingénieurs moins joueurs.) Un mot tout de suite sur le vocabulaire, parce que la confusion est partout depuis dix jours : un index n’est pas un moteur. Avoir un index, c’est avoir un stock de pages. Avoir un moteur, c’est explorer le web en continu, le maintenir à jour et classer les résultats sans dépendre de personne. OpenAI a le premier. Pas encore le second. J’y consacre une partie entière plus bas, parce que c’est là que se jouent les vraies décisions. Je fais ici le point sur ce que l’on sait réellement de Labrador, chiffres à l’appui, sur ce que cela change pour les sites français, et sur les pistes concrètes pour y être présent. Au sommaire
- Labrador en bref : la définition
- Comment Labrador a été découvert
- Non, ChatGPT n’a pas « son propre moteur »
- Pourquoi OpenAI construit son propre index
- Comment fonctionne Labrador : trois étages
- Le chiffre qui change tout : qui voit quoi
- Ce que l’on sait et ce que l’on ne sait pas
- Et en France ?
- Comment apparaître dans Labrador : 10 pistes concrètes
- Questions fréquentes sur Labrador
Labrador en bref : la définition
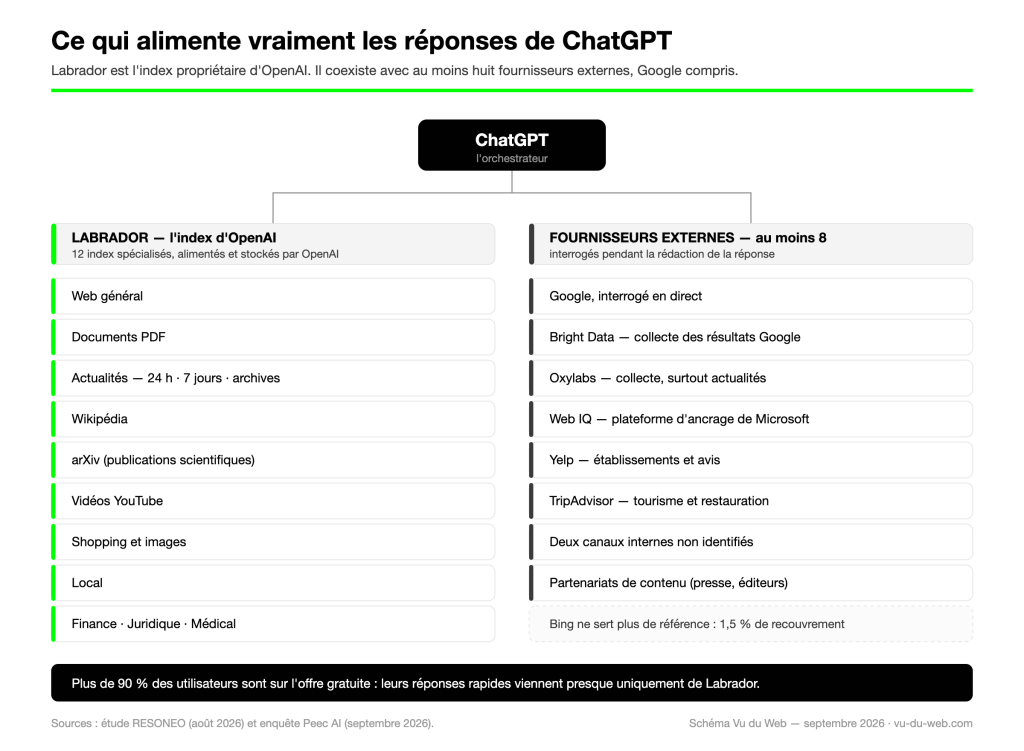
Labrador est l’index de recherche propriétaire d’OpenAI. Il stocke le texte de pages web, leurs dates d’exploration et de publication, et sert de première source de documents à ChatGPT, en particulier en mode de réponse rapide (« Instant »). Ce n’est pas un index unique mais une famille d’index spécialisés, complétée par des sources externes (résultats Google collectés par des prestataires, flux d’actualités, Yelp, TripAdvisor…).
Ce qu’il faut retenir en trois points :
- Labrador n’est pas Bing. Ses résultats, ses extraits et ses titres ne correspondent pas à ceux de Bing.
- Labrador sert la grande majorité des réponses gratuites. C’est l’index « économique » d’OpenAI, celui qui répond vite et à moindre coût.
- OpenAI n’a jamais communiqué officiellement sur Labrador. Tout ce que nous savons vient d’analyses indépendantes, détaillées ci-dessous.
Pour le contexte, OpenAI a lancé sa recherche web intégrée à l’été 2024 sous le nom de SearchGPT (nous en parlions déjà dans la sortie de la bêta SearchGPT). Deux ans plus tard, la brique qui manquait est en train d’arriver : l’index.
Comment Labrador a été découvert
Labrador n’a pas été annoncé. Il a été observé. Quand ChatGPT génère une réponse, ses serveurs envoient au navigateur un flux de données en temps réel (les server-sent events). Entre le 21 mai et le 21 juillet 2026, ce flux contenait un champ nommé result_source, qui indiquait l’origine de chaque résultat de recherche. Quatre valeurs y apparaissaient :
Valeur result_source | Ce que c’est (selon les analyses) |
|---|---|
| labrador | L’index propre à OpenAI |
| bright | Résultats Google collectés via le prestataire Bright Data |
| oxylabs | Résultats collectés via Oxylabs (surtout actualités) |
| serp | Pages de résultats externes |
Le 21 juillet 2026, le champ a disparu du flux. Trop tard : plusieurs équipes avaient déjà eu le temps de l’exploiter. Deux travaux font référence :
- L’étude de RESONEO, menée par Olivier de Segonzac (que j’ai eu la chance de rencontrer au SEO Summit 2025), publiée sur Search Engine Land et Abondance début août 2026. Échantillon : 1 200 réponses de ChatGPT, 88 000 résultats de recherche, 26 900 pages distinctes, des pages témoins sur leur propre domaine avec journaux serveur complets, et une flotte de comptes gratuits et payants.
- L’enquête de Peec AI, publiée le 4 septembre 2026 par Tomek Rudzki, qui a cartographié les sous-index de Labrador et repéré des expériences internes en cours.
C’est sur ces deux sources, et sur la documentation officielle d’OpenAI, que repose la suite de cet article.
Non, ChatGPT n’a pas « son propre moteur »
Le titre de l’enquête de Peec AI, « ChatGPT built its own search index », a été repris partout en quelques jours, souvent transformé en « ChatGPT a son propre moteur de recherche ». C’est faux, et son auteur le reconnaît lui-même en conclusion. Olivier Duffez (WebRankInfo) l’a formulé le plus clairement : ChatGPT n’a pas son propre moteur, il a un index en construction depuis 2023, avec au moins huit fournisseurs autour, Google compris. Je partage cette lecture, et je préfère le dire avant de vous vendre une révolution. Trois faits solides soutiennent cette nuance.
1. Google est toujours interrogé en direct, pendant la réponse
Malte Landwehr (Peec AI) a pris un site sans aucun trafic et ne l’a interrogé que dans ChatGPT, certains jours seulement. La Search Console de ce site a enregistré des pics de requêtes précisément ces jours-là. Conclusion difficile à contourner : ChatGPT interroge Google pendant qu’il rédige. Cela colle d’ailleurs aux 75,3 % de résultats issus de Google chez les abonnés payants (voir le tableau plus bas).
2. Huit fournisseurs, pas un moteur
Au-delà de Labrador, l’enquête identifie au moins huit sources externes dans le flux : Bright Data et Oxylabs (qui collectent Google), Google directement, Web IQ (la plateforme d’ancrage de Microsoft), Yelp, TripAdvisor, et deux canaux internes non identifiés. Ajoutez les partenariats de contenu (actualités, Wikipédia, arXiv, YouTube) et vous obtenez le portrait exact de la chose : ChatGPT est un chef d’orchestre, pas un moteur.
3. OpenAI le dit lui-même
Nick Turley a déclaré sous serment que l’indépendance totale vis-à-vis des fournisseurs tiers prendrait au moins cinq ans, même avec un accès complet aux données de Google. Dan Petrovic rappelle de son côté qu’un index frais et complet du web est un chantier de dix ans : Bing, seul concurrent sérieux de Google sur ce terrain, en est la démonstration vivante. Michael King observe qu’une grande partie des requêtes reste traitée en temps réel malgré l’index. Et John Campbell note que des sites qui bloquent GPTBot apparaissent quand même en mode lockdown, probablement via un fournisseur tiers, ce qui pose une question encore ouverte : quel robot alimente réellement Labrador ? Tomek Rudzki lui-même admet ne pas le savoir. Dernier point de méthode, et il est important : tout cela vient d’un flux de débogage qu’OpenAI peut fermer du jour au lendemain, comme il l’a fait le 21 juillet pour le champ de provenance. Ce que nous observons est réel. Ce n’est pas garanti stable.
Ce qu’on peut affirmer, et rien de plus : OpenAI construit un index, le teste en production sur une partie des conversations, et s’appuie toujours sur Google, Microsoft et six autres fournisseurs pour le reste. Ce n’est pas une révolution accomplie. C’est une bascule en cours, et elle se prépare maintenant.
Pourquoi OpenAI construit son propre index
1. La qualité des partenaires ne suffisait pas
Le 22 avril 2025, lors du procès antitrust opposant le département de la Justice américain à Google, Nick Turley, responsable de ChatGPT chez OpenAI, a témoigné sous serment (compte rendu de Courthouse News). Il a expliqué que ChatGPT s’appuyait alors sur les données de recherche de Bing, avec des « problèmes de qualité importants » chez l’un de ses fournisseurs. OpenAI avait sollicité Google l’année précédente pour accéder à son API de recherche. Google a refusé. Il a aussi révélé qu’OpenAI développait son propre index, avec un objectif initial de 80 % des recherches servies par cet index d’ici fin 2025, objectif repoussé de plusieurs années selon ses propres mots. (Attention si vous relayez l’information : plusieurs synthèses parues cette semaine indiquent « fin 2023 ». Le compte rendu d’audience, lui, dit fin 2025. J’ai vérifié, c’est cette version que je retiens.)
2. L’échelle rend la dépendance intenable
Fin février 2026, OpenAI revendiquait 900 millions d’utilisateurs actifs par semaine (TechCrunch). À ce volume, payer un tiers pour chaque requête de recherche devient un poste de coût colossal, et une dépendance stratégique vis-à-vis de concurrents directs (Microsoft est actionnaire, Google est l’adversaire).
3. Maîtriser l’index, c’est maîtriser le classement
Qui possède l’index décide de ce qui est vu. Les offres d’emploi d’OpenAI mentionnent d’ailleurs des systèmes de données à l’« échelle de l’exaoctet » (1018 octets). On ne construit pas ce type d’infrastructure pour un prototype. C’est la suite logique d’une stratégie déjà visible avec le navigateur web d’OpenAI, concurrent de Chrome : posséder toute la chaîne, de la porte d’entrée à la réponse. Le paradoxe de 2026 : OpenAI s’appuie encore sur Google pour ses réponses les plus poussées… tout en construisant l’outil qui doit lui permettre de s’en passer.
Comment fonctionne Labrador : trois étages
L’étude RESONEO décrit une architecture en trois niveaux. C’est la partie la plus importante pour comprendre où se joue votre visibilité.
Étage 1 : l’index (les titres et un extrait de 200 caractères)
Pour chaque page, Labrador conserve :
- le titre complet, sans troncature (un titre de 289 caractères a été observé tel quel) ;
- un extrait figé d’environ 200 caractères, identique quelle que soit la requête, ancré sur le H1 et le texte visible qui le suit (catégories, auteur, date, sommaire, texte alternatif des images) ;
- les dates d’exploration et de publication.
Point capital : la meta description est ignorée par Labrador. Elle reste utilisée par les résultats Google collectés (le canal bright la reprend dans environ un tiers des cas), mais pas par l’index d’OpenAI.
Étage 2 : le cache (la page complète, convertie en texte)
Quand une page est effectivement consultée, ChatGPT la convertit du HTML en Markdown et la stocke dans un cache partagé par tous les utilisateurs.
- Une copie est considérée « fraîche » pendant environ 30 minutes ;
- au-delà, la copie ancienne est servie pendant qu’un rafraîchissement est lancé en arrière-plan ;
- la fréquence de rafraîchissement dépend uniquement de la demande des utilisateurs : une page très sollicitée reste à jour, une page peu demandée peut vieillir indéfiniment. Des copies de plus de 90 jours ont été observées ;
- les directives
Cache-Controln’ont pas été respectées lors des tests.
Conséquence directe : la fraîcheur de contenu ne se décrète plus seulement par une date de mise à jour. Dans ChatGPT, une page reste fraîche parce qu’elle est demandée.
Étage 3 : la lecture en direct (réservée aux réponses « réfléchies »)
En mode « réflexion » (Thinking), ChatGPT peut ouvrir réellement une page via son robot ChatGPT-User. C’est coûteux, lent, et donc réservé aux cas où l’utilisateur accepte d’attendre. C’est aussi dans ce mode que ChatGPT multiplie les requêtes dérivées (le query fan-out) pour élargir sa recherche.
Ce que l’on sait aussi des sous-index
Selon Peec AI, Labrador se décline en 12 index verticaux : web général, PDF, YouTube, actualités (dernières 24 h, 7 derniers jours, archives), arXiv, Wikipédia, local, finance (avec un sous-index PDF dédié), juridique, médical, shopping et images. Pour le shopping, la pile de classement combine une recherche lexicale classique (BM25), un reclassement sur un vivier de 400 candidats et une recherche vectorielle (vecteurs de 12 288 et 4 096 dimensions). Rien d’exotique : c’est l’architecture d’un moteur de recherche moderne.
Le chiffre qui change tout : qui voit quoi
C’est ici que Labrador devient un sujet business. Tous les utilisateurs de ChatGPT ne sont pas servis par les mêmes sources.
| Gratuit – Instant | Gratuit – Réflexion | Payant – Réflexion (effort moyen) | |
|---|---|---|---|
| URL par conversation | 15,1 | 35,3 | 33,9 à 47,2* |
| Domaines distincts | 9,8 | 16,3 | 15,5 à 21,9* |
| Part de Labrador | Quasi exclusive | 74,7 % | 24,7 % |
| Part de Google (collecté) | — | 3,1 % | 75,3 % |
| Pages réellement ouvertes | Non (93 % des réponses) | Oui | Oui |
Traduction :
- Plus de 90 % des utilisateurs de ChatGPT sont sur l’offre gratuite. Leurs réponses rapides sont construites à partir de Labrador, sur la base des titres et des extraits de 200 caractères, sans qu’aucune page ne soit ouverte dans 93 % des cas.
- Les abonnés payants, eux, reçoivent majoritairement des résultats issus de Google.
La hiérarchie qui en découle est simple et brutale : pour la masse des utilisateurs, votre visibilité dans ChatGPT se joue sur votre titre et vos 200 premiers caractères dans Labrador.
L’entonnoir de citation
L’étude a aussi mesuré ce qui se passe entre « être trouvé » et « être cité » :
- 61 332 URL apparues dans le panneau des sources ;
- 5 032 devenues source principale d’une citation ;
- 759 pages réellement ouvertes (mode réflexion uniquement) ;
- une page ouverte est citée dans 74 % des cas, contre 7 % pour une page seulement récupérée.
Un exemple parlant : arXiv a été récupéré plus de 2 600 fois pour… 10 citations. Reddit affiche le même ratio (ce qui nuance un peu l’idée de Reddit, incontournable du GEO : présent, oui ; cité, beaucoup moins). Être dans l’index ne suffit pas. Il faut être la page que le modèle a envie d’ouvrir.
Pour aller plus loin : ChatGPT ne cite pas tout le monde : ce que révèlent les données de SE Ranking →
Ce que l’on sait et ce que l’on ne sait pas
Je tiens à cette distinction. Sur un sujet aussi récent, le risque est de transformer des observations en certitudes.
| On le sait (observé et mesuré) | On ne le sait pas encore |
|---|---|
| Labrador est un index distinct de Bing (1,5 % de recouvrement) | Quel robot alimente réellement Labrador : OAI-SearchBot est « presque silencieux » dans les journaux |
| Les titres sont conservés en entier, la meta description est ignorée | Comment les vidéos YouTube sont intégrées (aucun partenariat public connu) |
| Le JavaScript n’est pas exécuté, le JSON-LD est supprimé | La part exacte des citations issues de la mémoire du modèle plutôt que de la recherche |
| Les pages de plus de 4 Mo sont rejetées | Les critères de classement précis de Labrador pour le web général |
| OpenAI teste la préférence de son index face aux résultats externes | Le calendrier de bascule complète vers Labrador |
| ChatGPT interroge Google en direct pendant qu’il répond (pics relevés dans la Search Console d’un site témoin) | La part de chaque fournisseur dans le temps, et à quelle vitesse Labrador prend le dessus |
| Au moins huit fournisseurs externes coexistent avec Labrador | Si OpenAI vise l’indépendance totale ou un assemblage durable |
Un signal fort, tout de même : à la mi-août 2026, une expérience interne nommée prefer-index-over-serp-v3 concernait 8 % des conversations (tests shopping). Et un test indépendant rapporté par Peec AI (mené par le chercheur Metehan), un site de un milliard de pages publié pour mesurer l’appétit du robot, affichait début septembre 6 millions de pages explorées au rythme de 35 000 requêtes par heure. Le chien a faim. Dernière précaution : OpenAI change vite. Le champ result_source a disparu en une nuit, le nombre de requêtes par conversation a chuté de 47 % en un mois chez les abonnés. Ce qui est vrai en septembre 2026 ne le sera peut-être plus en décembre.
Et en France ?
Soyons clairs : il n’existe pas, à ce jour, de donnée publique mesurant Labrador spécifiquement sur le marché français. Les études précédemment citées portent sur le fonctionnement global de ChatGPT, sans ventilation par pays. Tous ceux qui vous annonceront « l’impact de Labrador en France » avec un pourcentage précis inventent. En revanche, on peut poser le contexte avec des chiffres fiables :
- 54 % des Français déclarent utiliser ChatGPT, et 98 % continuent d’utiliser les moteurs de recherche classiques (OpinionWay pour SEO.fr, mai 2026, 1 013 personnes interrogées).
- ChatGPT comptait 18,3 millions de visiteurs uniques par mois en France et 4,2 millions par jour en mai 2025 (Médiamétrie), soit un triplement en un an.
- Le trafic provenant des plateformes d’IA ne représente encore que 0,26 % du trafic total des sites français (janvier-avril 2026), et ChatGPT pèse 77,2 % de ce trafic IA (SE Ranking, 101 574 sites analysés).
- La recherche organique représente 56,4 % du trafic des sites français, contre 44,7 % au niveau mondial (même source). La France reste un marché très « Google ».
J’ai compilé les autres indicateurs d’usage dans mes statistiques ChatGPT France et monde. Ce que j’en tire, pour le marché français :
- Le trafic mesuré est faible, l’exposition est massive. 0,26 % de trafic, c’est peu. Mais des millions de Français lisent chaque jour des réponses construites à partir de titres et d’extraits, sans cliquer. Votre marque est citée (ou pas) bien avant d’être visitée.
- Le gros de l’audience française est sur l’offre gratuite. Donc, au vu du fonctionnement observé, servi majoritairement par Labrador. Si vous pilotez votre visibilité ChatGPT en regardant vos positions Bing, vous regardez le mauvais tableau de bord. (Les métriques GEO de Bing Webmaster Tools restent précieuses pour Copilot, pas pour ChatGPT.)
- Beaucoup de sites français sont techniquement mal armés. Chez Vu du Web, nous auditons régulièrement des sites d’écoles, de collectivités et d’e-commerçants construits sur des cadres JavaScript lourds, avec des titres pensés pour être tronqués à 60 caractères et une accroche noyée sous un bandeau cookies, un carrousel et trois widgets. Pour Labrador, ce sont précisément les 200 caractères qui comptent.
Comment apparaître dans Labrador : 10 pistes concrètes
Voici les actions que je recommande aujourd’hui, classées de la plus fondamentale à la plus avancée. Aucune ne garantit une citation. Toutes augmentent vos chances d’être trouvé, compris et repris.
1. Ouvrez la porte à OAI-SearchBot
C’est le prérequis officiel. Selon la documentation d’OpenAI, OAI-SearchBot est le robot qui sert à faire apparaître les sites dans la recherche de ChatGPT. Vérifiez votre robots.txt :
User-agent: OAI-SearchBot
Allow: /
Distinguez-le bien de GPTBot (entraînement des modèles) : vous pouvez bloquer l’un et autoriser l’autre. OpenAI indique qu’un changement de robots.txt est pris en compte en environ 24 heures. Vérifiez aussi que votre pare-feu ou votre CDN ne bloque pas ces robots par défaut (c’est plus fréquent qu’on ne le pense).
2. Rendez votre contenu lisible sans JavaScript
Labrador n’exécute pas le JavaScript. Tout contenu injecté côté navigateur est invisible. Faites le test : désactivez JavaScript et rechargez vos pages clés. Ce qui disparaît n’existe pas pour ChatGPT. Rendu serveur ou génération statique pour vos pages stratégiques. C’est l’un des premiers points que nous contrôlons lors d’un audit SEO.
3. Écrivez un titre qui se suffit à lui-même
Le titre arrive au modèle en entier. Arrêtez d’écrire pour la troncature Google à 60 caractères et d’empiler des mots-clés séparés par des tirets. Écrivez une phrase qui dit clairement ce que contient la page, pour qui, et avec quelle promesse.
| Avant | Après |
|---|---|
| Swiss Ball 65 cm – Ballon Fitness – Pas cher – Livraison | Swiss Ball 65 cm : quel ballon choisir si vous mesurez entre 1,65 m et 1,80 m |
(Gardez un œil sur Google : un titre long sera tronqué dans ses résultats. L’idée est d’avoir le message principal au début.)
4. Soignez les 200 premiers caractères après votre H1
C’est le seul texte de votre page que le modèle voit en mode Instant. Placez-y la réponse, pas l’introduction. Une définition, un chiffre, une promesse claire. Déplacez sous ce bloc les fils d’Ariane, les bandeaux promotionnels et les métadonnées qui polluent l’extrait. (Vous remarquerez que cet article commence ainsi. On applique ce qu’on recommande.) Je détaille d’autres réglages de ce type dans mes 8 conseils SEO on-page pour les LLM.
5. Travaillez le texte alternatif des images placées en haut de page
Le texte alternatif survit à la conversion en Markdown et fait partie de ce qui est lu autour du H1. Une image d’en-tête avec un alt descriptif et informatif, c’est du texte gratuit dans votre extrait. En mars 2025, dans notre guide sur l’optimisation des images pour SearchGPT, nous recommandions de soigner les textes alternatifs… et de prioriser l’indexation Bing. Le premier conseil se confirme. Le second est à revoir : c’est exactement ce que Labrador change.
6. Ne comptez pas sur les données structurées pour ChatGPT
Le JSON-LD est supprimé lors de la conversion. Je le reconnais volontiers : en 2025, j’écrivais qu’il fallait miser sur les données structurées pour le SEO et le GEO. C’est toujours vrai pour Google et ses AI Overviews. Pour ChatGPT, les observations de 2026 montrent que le balisage n’arrive pas jusqu’au modèle par ce chemin. Conservez-le donc, mais toute information importante (prix, auteur, date, note, disponibilité) doit aussi apparaître en texte visible.
7. Gardez vos meta descriptions
Paradoxe apparent : Labrador les ignore, mais les résultats Google collectés par ChatGPT pour les abonnés les reprennent dans environ un tiers des cas. Ce n’est pas le moment de les abandonner.
8. Surveillez le poids de vos pages
Au-delà de 4 Mo, la page est rejetée, pas tronquée. Les pages produits gavées de scripts, les pages de catégorie à défilement infini et certains constructeurs de pages dépassent ce seuil plus souvent qu’on ne l’imagine.
9. Pensez « verticaux », pas seulement « web »
Labrador a des index dédiés aux PDF, aux vidéos YouTube, aux actualités, à Wikipédia et au shopping. Concrètement :
- vos livres blancs et études en PDF sont une porte d’entrée à part entière : titrez-les, structurez-les, rendez-les accessibles sans formulaire pour au moins une version ;
- vos vidéos YouTube entrent dans le jeu : titres et descriptions explicites ;
- pour l’e-commerce, les flux marchands et les fiches produits comptent plus que l’article de blog (c’est tout le travail de notre pôle SEO e-commerce) ;
- pour le local, ChatGPT s’appuie sur des sources comme Yelp et TripAdvisor : vérifiez votre présence et vos avis sur ces plateformes, pas seulement sur Google.
Plus largement, votre visibilité dépend aussi de ce que les autres publient sur vous : c’est le sujet des sources tierces dans les LLM.
10. Mesurez ce qui compte vraiment
ChatGPT ajoute utm_source=chatgpt.com aux liens cliqués (FAQ éditeurs d’OpenAI). Mais les pages lues en mode réflexion ne portent aucun paramètre UTM : votre outil d’analyse voit les clics, pas les lectures. Pour mesurer votre exposition réelle :
- analysez vos journaux serveur et suivez les passages de
OAI-SearchBotet deChatGPT-User(ce dernier signale une page ouverte en direct, donc une probabilité de citation élevée) ; - suivez vos pages les plus lues par ChatGPT-User : ce sont vos meilleurs actifs GEO ;
- complétez par un suivi de citations sur un panel de questions fixes, rejouées chaque mois (voir nos 15 KPIs pour mesurer la performance dans un LLM).
Bonus : le test du mode lockdown, en dix minutes
Celui-ci ne coûte rien et il est parlant. Passez ChatGPT en mode lockdown, celui qui lui interdit de naviguer, puis demandez-lui le contenu de vos pages clés, ou votre dernier article publié.
- Il répond avec du contenu à jour ? Il le sert depuis son cache : vos pages y sont, et la version stockée est récente.
- Il répond avec une version périmée ? Vous mesurez l’âge de la copie détenue sur vous. C’est exactement le point traité plus haut sur la fraîcheur.
- Il ne connaît pas la page ? Vous avez un problème d’accès, de JavaScript ou de robots.txt à traiter en priorité.
Faites-le sur cinq pages : une page d’accueil, deux pages de service ou produit, deux articles. En dix minutes vous saurez ce que ChatGPT détient réellement sur vous, sans aucun outil payant.
Pour aller plus loin : GEO (Generative Engine Optimization) : le SEO sur ChatGPT, Gemini et Perplexity →
À propos de l’auteur
Sébastien Vallat expert en référencement SEO et GEO (Generative Engine Optimization) depuis plus de 15 ans. Je suis fondateur de Vu du Web, agence spécialisée en SEO et GEO, qui accompagne depuis 2013 les établissement d’enseignement, entreprises et institutions françaises dans leur stratégie de visibilité sur les moteurs de recherche traditionnels (Google, Bing) et génératifs (AI Overviews, ChatGPT, Perplexity, Gemini). Retrouvez mes analyses et recommandations sur sebastien-vallat.com et découvrez comment Vu du Web peut optimiser votre visibilité dans l’écosystème SEO/GEO.
Questions fréquentes sur Labrador
ChatGPT a-t-il son propre moteur de recherche ?
Non, pas encore. ChatGPT dispose d’un index propriétaire, Labrador, qu’il utilise pour une partie de ses réponses, mais il s’appuie toujours sur au moins huit fournisseurs externes, dont Google et Microsoft. Un index n’est pas un moteur : il manque encore l’exploration continue du web et l’indépendance de classement.
Labrador est-il un moteur de recherche accessible au public ?
Non. C’est un index interne à OpenAI, utilisé par ChatGPT pour trouver des documents. Il n’a pas d’interface publique ni de documentation officielle.
Faut-il encore travailler son référencement Bing pour ChatGPT ?
Bing reste utile pour Copilot et pour sa propre audience, mais il n’est plus un bon indicateur de votre visibilité dans ChatGPT : moins de 2 % de recouvrement a été mesuré entre Labrador et le top 20 de Bing.
Et Google ?
Google reste central : il alimente environ trois quarts des résultats des réponses « réfléchies » des abonnés payants. Un bon référencement Google reste un atout pour ChatGPT, mais il ne couvre pas les réponses rapides de l’offre gratuite.
Comment savoir si ChatGPT lit mes pages ?
Par vos journaux serveur : recherchez les agents OAI-SearchBot et ChatGPT-User. Les plages d’adresses IP officielles sont publiées par OpenAI pour vérifier l’authenticité des visites.
Bloquer GPTBot m’empêche-t-il d’apparaître dans ChatGPT ?
Non. GPTBot concerne l’entraînement des modèles. C’est OAI-SearchBot qui conditionne l’apparition dans la recherche de ChatGPT. Pendant vingt ans, on a optimisé pour un moteur dont on connaissait les règles. Avec Labrador, OpenAI construit un index dont les règles s’observent, se mesurent, mais ne se publient pas. La question n’est pas de savoir si ChatGPT est déjà un moteur de recherche à part entière : il ne l’est pas, et pas avant plusieurs années.
Sources
- Olivier de Segonzac (RESONEO), Inside ChatGPT’s retrieval stack, Search Engine Land, août 2026
- Dans la stack de retrieval de ChatGPT, Abondance, 5 août 2026
- Tomek Rudzki, ChatGPT built its own search index, Peec AI, 4 septembre 2026
- ChatGPT a construit son propre index de recherche, Abondance, 8 septembre 2026
- ChatGPT is quietly building its own search engine, Search Engine Watch, 4 septembre 2026
- Olivier Duffez (WebRankInfo), « ChatGPT n’a pas son propre moteur », LinkedIn, septembre 2026
- Témoignage de Nick Turley, Courthouse News Service, 22 avril 2025
- OpenAI, Overview of OpenAI Crawlers
- OpenAI, Publishers and Developers FAQ
- TechCrunch, ChatGPT reaches 900M weekly active users, 27 février 2026
- SE Ranking, Le trafic de l’IA en France en 2026, juin 2026
- Next, ChatGPT triple son audience en France (Médiamétrie, mai 2025)
- OpinionWay pour SEO.fr, mai 2026 (via ABC Digital Marketing)
Articles récents dans la même catégorie
Juil 08 2026 | Sebastien Vallat
AI Overviews : 2 ans de données pour évaluer les changement d’habitudes des internautes
Lire l’article →
Avr 22 2026 | Sebastien Vallat
Lycéens et IA : ce qui a changé entre 2025 et 2026 en France, en Europe, aux États-Unis
Lire l’article →
Nov 26 2025 | Sebastien Vallat